Cloudflare veut suivre le comportement des robots déjà vérifiés
Un robot d’exploration est un logiciel qui visite automatiquement des pages, par exemple pour alimenter un moteur de recherche. Savoir qui l’exploite aide à comprendre ces visites ; il faut aussi regarder comment elles se déroulent. Le 16 octobre 2026, Cloudflare présente un système qui évalue dans la durée le comportement de ses robots vérifiés. L’entreprise indique l’utiliser actuellement en interne et prévoit une ouverture à ses clients. Le réglage d’un seuil de confiance par le client fait partie de ce projet, pas d’une disponibilité générale démontrée par l’annonce.
Pour le responsable d’un site, cette distinction est utile lorsqu’un trafic automatisé est autorisé parce que son identité est connue. Le besoin d’être exploré et celui de garder un site disponible doivent être examinés ensemble. Une exception trop large mérite d’être comprise avant de devenir une règle permanente.
Deux signaux, avec des rôles différents
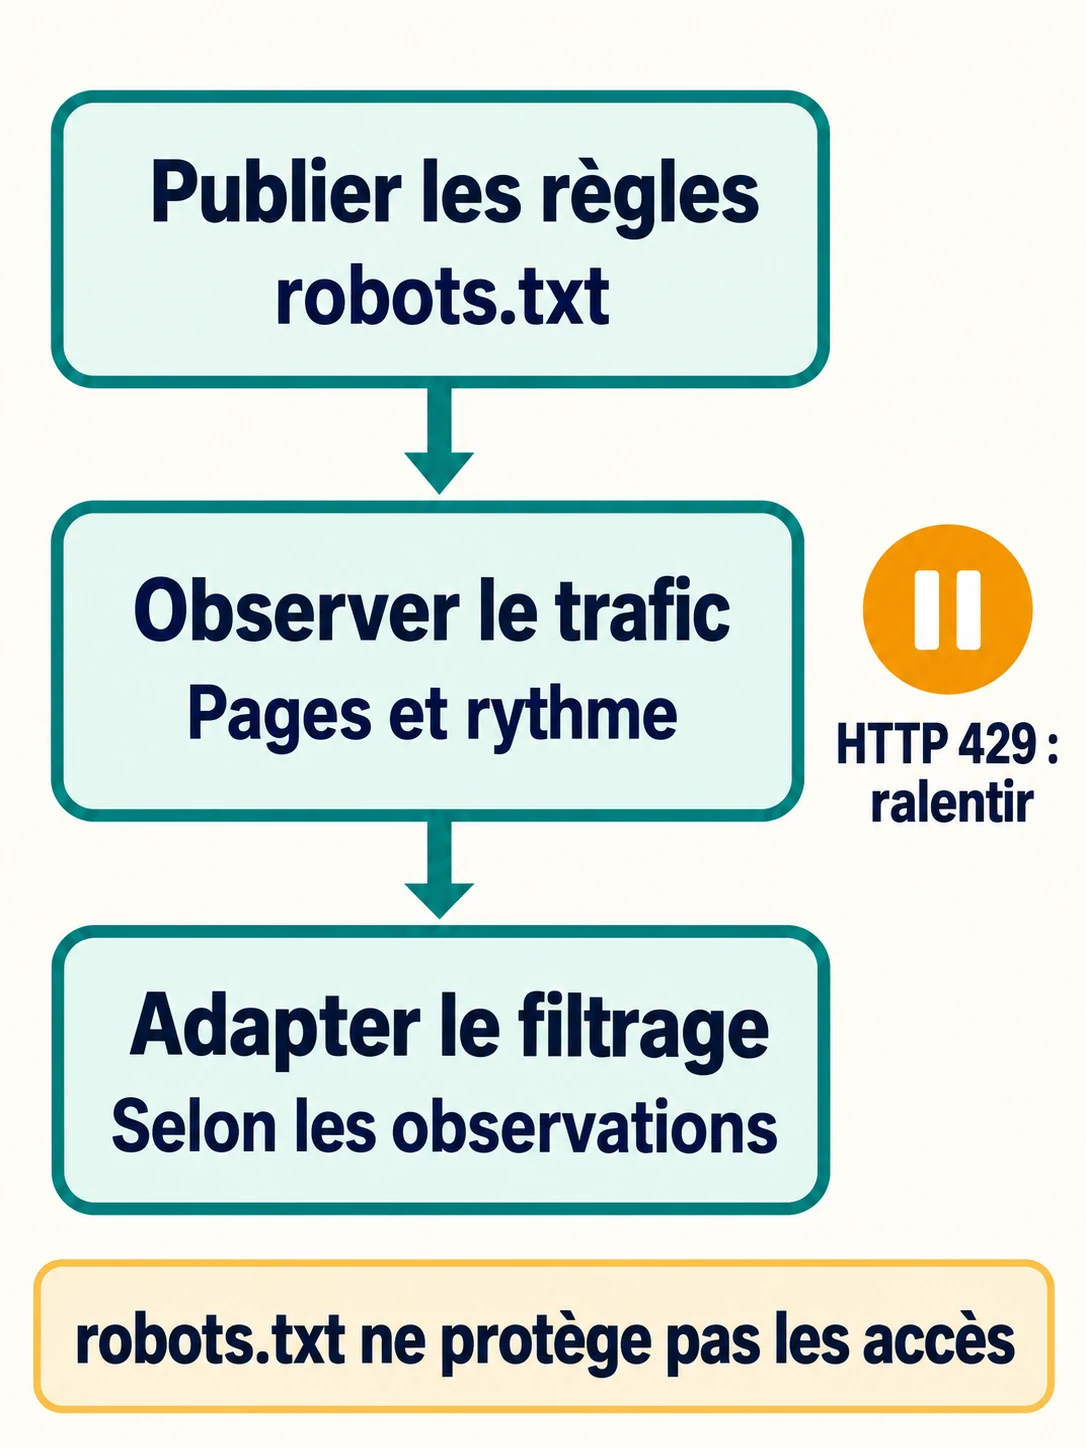
Le dispositif annoncé regarde le respect des préférences publiées dans robots.txt et la réaction aux réponses HTTP 429. Cloudflare décrit une appréciation fondée sur des comportements répétés, avec une plage de confiance explicable. La publication publique des évaluations sur Radar est annoncée pour plus tard. Ces éléments sont décrits dans la présentation du système ; ils ne donnent pas une note de sécurité universelle à chaque visite.
robots.txt est un fichier public qui indique aux robots les chemins à explorer ou à éviter. La norme du protocole, RFC 9309 précise que ces règles ne constituent pas une autorisation d’accès et ne remplacent pas les protections du contenu. Un document confidentiel doit donc être protégé par un contrôle d’accès adapté. Le mentionner seulement dans ce fichier laisserait son chemin publiquement découvrable.
HTTP est le protocole d’échange utilisé pour les pages web. Son code 429 signifie que trop de requêtes ont été reçues dans un intervalle donné. La RFC 6585 prévoit la possibilité d’accompagner cette réponse d’un délai d’attente. Le signal porte sur le rythme ; il ne dit pas que l’identité du visiteur est fausse. Inversement, la bonne identité d’un robot ne dispense pas de limiter une charge excessive.
Relier chaque règle à ce qui doit rester accessible
Imaginez un catalogue public parcouru par un moteur et une recherche interne générant de nombreuses combinaisons de pages. Le dirigeant veut que les fiches produits soient découvertes ; il n’a pas nécessairement besoin que chaque combinaison soit revisitée au même rythme. Ce scénario hypothétique invite à distinguer les espaces utiles et le coût des visites avant d’interdire ou d’autoriser tout un ensemble de robots.
- Décrire l’objectif : quelles pages doivent pouvoir être découvertes et quels espaces demandent une protection d’accès ?
- Demander des observations : quels chemins sont parcourus, à quels moments et avec quels effets sur le site ?
- Relire les exceptions : une règle laisse-t-elle passer tous les robots vérifiés, et qui l’a décidée ?
- Préparer le contrôle après changement : vérifier à la fois la disponibilité du site et l’accès des robots utiles.
La lecture d’un pic demande aussi de rapprocher les visites et l’état du serveur. Une hausse de trafic et une lenteur simultanées justifient une investigation ; elles ne suffisent pas à désigner une cause. Gardez les dates, les règles modifiées et les observations disponibles afin que le prestataire puisse expliquer son diagnostic. Cette démarche reste applicable sans attendre l’ouverture du nouveau système.
Choisir le suivi adapté à votre site
Le sujet concret est de savoir ce qui est autorisé, observé et corrigé lorsque le trafic évolue. Les offres d’hébergement et de maintenance Gaia permettent de comparer les contrôles et les modalités d’intervention selon le niveau retenu. La page Cybersécurité présente aussi les protections complémentaires à examiner, dont Cloudflare. Le service exact, ses conditions et les données concernées doivent guider le choix du périmètre.
Poursuivre votre lecture
Retrouvez les autres articles du même sujet ou explorez une nouvelle catégorie.
-
WordPress : « ne pas indexer » ne veut pas dire « rendre privé »
Une page absente des résultats de recherche peut rester accessible par son adresse. Pour une préproduction ou un contenu réservé, visibilité et accès demandent deux décisions distinctes.
-
Microsoft 365 : inviter les collègues ne réserve pas la salle
Une réunion peut être inscrite dans les agendas des participants sans que la pièce soit réservée. La boîte de salle donne à ce lieu ses propres règles de réservation.
-
Au zoom, votre site laisse-t-il encore lire toute la ligne ?
Agrandir une page aide à lire, à condition que le contenu se réorganise. Le défilement horizontal révèle parfois un problème que la seule vue mobile ne montre pas.